Ausführungsreihenfolge vs. Datenabhängigkeit: Warum ein Ablaufplan Datenflüsse nicht ersetzen kann
Ein Ablaufplan legt fest, was nacheinander passiert. Ein Datenfluss bestimmt, was vorhanden sein muss. Warum eine falsche Reihenfolge beim Schnittstellen-Aufruf zu Datenmangel führt.
Ein Ablaufplan legt fest, was nacheinander passieren soll.
Eine Datenabhängigkeit bestimmt, welche Eingaben ein Schritt tatsächlich benötigt.
Diese beiden Sichten klingen ähnlich. In der Praxis der Softwarearchitektur stehen sie jedoch oft in einem direkten Widerspruch zueinander.
- Ablaufplan (Steuerfluss): Komponente A wird vor Komponente B aufgerufen.
- Datenfluss (Abhängigkeit): Komponente A benötigt Daten, die erst Komponente B erzeugt.
Wenn ein Schritt Daten benötigt, die erst später erzeugt werden, ist der geplante Ablauf nicht vollständig ausführbar. Die Reihenfolge im Diagramm stimmt dann nicht mit der Wirklichkeit der Daten überein.
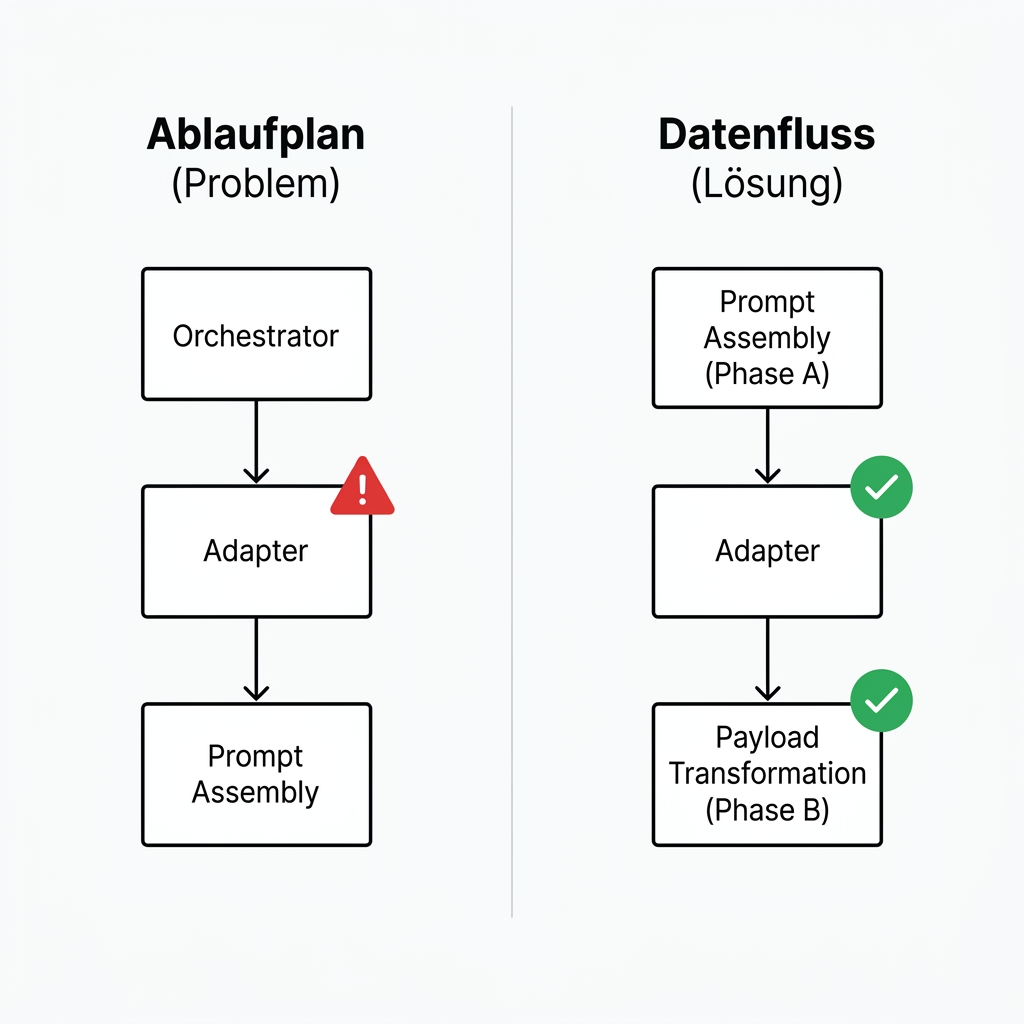
Das Problem in der Pipeline-Architektur
In einem internen Architektur-Review stießen wir auf genau diese Unstimmigkeit.
Das System verwendet drei beteiligte Bausteine:
- Ein Orchestrator: Er steuert den Gesamtablauf und ruft die einzelnen Schritte auf.
- Eine Transport-Komponente: Sie nimmt Daten entgegen und leitet sie an eine externe Schnittstelle weiter.
- Eine Komponente zur Eingabe-Vorbereitung: Sie liest Daten aus verschiedenen Quellen und stellt den finalen Prompt zusammen.
Der ursprüngliche Ablaufplan sah vor, dass der Orchestrator zuerst die Transport-Komponente aktiviert. Erst danach sollte die Eingabe-Vorbereitung gestartet werden.
Hier entstand der logische Widerspruch:
Die Transport-Komponente sollte einen fertigen, kompilierten Prompt an das externe Modell übergeben. Laut Ablaufplan existierte dieser Prompt zu diesem Zeitpunkt jedoch noch gar nicht. Die Eingabe-Vorbereitung lief ja erst im darauffolgenden Schritt.
Warum die Transport-Komponente den Prompt nicht selbst baut
Ein naheliegender Gedanke wäre: Warum baut die Transport-Komponente den Prompt nicht einfach selbst zusammen?
Das würde jedoch ein wichtiges Architekturprinzip verletzen: die Trennung der Zuständigkeiten (Separation of Concerns).
Die Transport-Komponente ist rein für die Schnittstellen-Verbindung, das Netzwerk und das Datenformat des Anbieters zuständig. Sie soll nicht wissen müssen, wie Prompts zusammengestellt oder Kontexte aufbereitet werden.
Die Eingabe-Vorbereitung wiederum kennt die Fachlogik und den Kontext, hat aber keine Kenntnis von Netzwerkdetails.
Wenn beide Aufgaben vermischt werden, entsteht enge Kopplung. Der Quelltext wird schwer testbar und anfällig für Fehler.
Die technische Benennung im Projekt
In der Projektdokumentation von BridGenta spiegeln sich diese Rollen in klaren Begriffen wider:
- WP-009 (Provider-Adapter): Die reine Transport-Schicht für externe Schnittstellen.
- WP-010 (Prompt-Kompilierung & Transformation): Die Fachschicht zur Eingabe-Zusammenstellung.
- ProviderExecutionEnvelope: Das Datenpaket, das den vorbereiteten Inhalt für den Transport kapselt.
In der ursprünglichen Arbeitsansetzung war geplant, den Adapter (WP-009) vor der Prompt-Kompilierung (WP-010) auszuführen. Die Spezifikationsprüfung deckte auf, dass der Adapter auf diese Weise keinen kompilierten Prompt erhalten konnte.
Die Lösung: Die Zwei-Phasen-Transformation
Um den Ablaufplan an den tatsächlichen Datenfluss anzupassen, wurde eine Architekturänderung empfohlen (Modell A).
Die Transformation wurde in zwei getrennte Phasen aufgeteilt:
- Phase A (Envelope Compilation): Zuerst bereitet die Eingabe-Vorbereitung alle Daten vor und erstellt das vollständige Transport-Paket (
ProviderExecutionEnvelope). - Adapter-Aufruf: Der Orchestrator übergibt dieses fertige Paket an die Transport-Komponente.
- Phase B (Payload Transformation): Nach der Antwort wandelt das System das Ergebnis in das finale Format um.
Durch diese Aufteilung entspricht der Ablaufplan wieder der echten Datenabhängigkeit. Jeder Schritt erhält genau die Daten, die er für seine Ausführung benötigt.
Wie die Umsetzung verifiziert wurde
Für die Qualitätssicherung ist es wichtig, den Nachweis-Status präzise abzugrenzen:
- Spezifikationsprüfung: Der Widerspruch wurde in den Architektur-Dokumenten (
ECP-WP009-001) identifiziert. - Codebasis-Umsetzung: Die Zwei-Phasen-Logik wurde in den Laufzeit-Modulen (
becc-runtime) implementiert. - Automatische Tests: Unit-Tests verifizieren, dass Phase A ein gültiges Envelope erzeugt und Phase B die Rückgabe korrekt umwandelt.
Gleichzeitig bleiben zwei Grenzen bestehen: Die formale Beschlussfassung der Spezifikationsänderung ist in den kanonischen Quellen nicht als eigener Freigabebeschluss dokumentiert (NOT_ESTABLISHED). Ein Produktivausfall durch die ursprüngliche Reihenfolge ist nicht belegt. Die Quellen dokumentieren den Widerspruch bereits auf Architektur- und Spezifikationsebene.
Übertragbare Erkenntnis für Softwareprojekte
Das Verhältnis von Steuerfluss und Datenfluss betrifft nahezu jede mehrstufige Softwarearchitektur:
- REST-APIs: Ein Client kann keine Detailressource abfragen, deren ID erst im nächsten Schritt erzeugt wird.
- ETL-Pipelines: Eine Transformation kann keine Spalten berechnen, deren Rohdaten noch nicht geladen wurden.
- Agenten-Systeme: Ein KI-Agent kann kein Werkzeug mit Ergebnissen aufrufen, die erst eine spätere Denkphase liefert.
Ein Ablaufplan ist eine Absichtserklärung über die Reihenfolge. Funktionsfähig wird ein System aber erst, wenn der Datenfluss jeden einzelnen Schritt mit seinen notwendigen Voraussetzungen versorgt.
Eine Reihenfolge im Ablaufplan ist noch kein funktionierender Datenfluss.